
ИИ-агент, запущенный в продукте для работы с аудиторией более 100 тыс. пользователей, в 76% случаев отвечал хорошо, и на момент замера его недельная активная аудитория составляла около 2 тыс. человек. Но что значит «хорошо в 76% случаев»? Хороший ответ — по чьему мнению? По каким критериям? Кто размечал и сходились ли разметчики между собой? Если нет ответа, то нельзя ни объективно оценивать ИИ-агента, ни сравнить его работу с прошлым месяцем, ни с другим агентом.
Подобные замеры нужны не ради отчета — оценка качества работы должна помочь ответить на два вопроса, от которых непосредственно зависит эффективность компании. Первый — можно ли вообще выпускать агента на пользователей? Агент полезен ровно настолько, насколько ему можно верить, а если он уверенно отвечает неправильно, пользователь получает неверный ответ, теряет деньги или время и все равно идет к оператору-человеку, а компания сталкивается с репутационными рисками. Второй — можно ли передать агенту работу, которую сейчас делают сотрудники? Недостаточно знать, что агент «в целом работает» — требуется сравнение с людьми на одних и тех же вопросах: на каких темах агент отвечает не хуже оператора, а на каких его без проверки нельзя подпускать к пользователю.
Ошибиться можно и в самой оценке, причем несимметрично: завышенная выпускает агента к пользователям раньше срока; заниженная заставляет команду месяцами чинить то, что и так работает.
Исследование [1] показало: 95% корпоративных пилотов генеративного ИИ не дали измеримого эффекта на прибыль. Причина обычно не в модели — команда просто не может показать, что стало лучше, потому что не построила систему измерения. Схожий вывод дает анализ сессионных логов терминальных ИИ-агентов [2]: результат внедрения определяет готовность инфраструктуры вокруг агента, а не работа с самой моделью.
Такую систему строят вместе с ИИ‑агентом, а не после его запуска.
Действующие лица
ИИ-агент: автономная или полуавтономная программа на базе ИИ, которая понимает цель, сама решает, что делать дальше, и выполняет многошаговые задачи, подключаясь к инструментам, API, базам данных и другим системам. Агент может планировать, действовать, проверять результат и при необходимости корректировать план без постоянного контроля человека.
Пользователь: клиент компании, который пишет агенту в чат. Поток — эти текстовые обращения, несколько тысяч в неделю.
База знаний: документы компании, по которым агент отвечает (справка, регламенты, таблицы тарифов).
Разметчик: человек, который читает диалоги и оценивает ответы по критериям. На старте это сама команда — продакты, аналитики, разработчики.
Асессор: нанятый исполнитель, который размечает диалоги по готовой инструкции. Не участвует в разработке агента. Например, исполнители краудсорсинговых платформ вроде «Яндекс.Толоки».
Редакция: команда, отвечающая за тексты продукта (интерфейс, письма, справку) и задающая тональность и правила языка.
Модель-судья (LLM-as-a-judge): языковая модель, которой отдают ту же инструкцию по разметке, что и людям, чтобы размечать тысячи диалогов вместо десятков.
Оператор: сотрудник поддержки, которому агент передает диалог, когда сам не берется отвечать.
Чьи ответы замерять?
Перед тем как делать сложное ML-решение, возьмите ожидаемый датасет вопросов и прогоните на нем разные модели. Чью модель использовать: обучать свою, ходить в чужой API? Поднять на своем оборудовании чужие открытые веса, то есть модель, опубликованную вместе с обученными параметрами: ее можно скачать и запустить в своем контуре? Первый вариант — самый долгий. Гипотезу о том, что продукту нужен ИИ-агент, лучше проверять на внешней модели, а при работе с данными под NDA — на чужих весах, развернутых у себя. Но у чужой модели есть цена, которую платят не только деньгами — возникает зависимость от поставщика. Версии моделей, цены и условия доступа он меняет в своем ритме, а не в вашем. Кроме этого рынок готовых моделей меняется быстрее, чем корпоративный цикл закупки. По оценке [3], в 2025 году компании потратили на API языковых моделей 12,5 млрд долл. Доли поставщиков: Anthropic — 40%, OpenAI — 27%, Google — 21%. Двумя годами раньше OpenAI держал половину рынка. Архитектура, намертво «прибитая» к одному поставщику, устареет раньше, чем окупится.
Таким образом, требование к архитектуре — модель должна меняться без переписывания продукта. Обращение к ней надо держать за своим интерфейсом, а датасет вопросов — неизменным. В этом случае смена поставщика — это один прогон на том же наборе вопросов и сравнение двух показателей, а не отдельный проект на квартал.
Мы начинали с внутреннего решения компании, и после первых прогонов оказалось, что оно проигрывало внешним моделям на корпоративном наборе вопросов. Это подтверждается и оценками пользователей — на вопросах про тарифы универсальная внешняя модель отвечает лучше.
Но после дообучения своей модели на собственных данных разрыв почти закрылся. В продакшн пошла своя модель — качество почти не уступало внешним, а данные остались внутри контура. Внешние модели остались в роли эталона. На каждом крупном изменении через обе модели прогонялся один и тот же датасет вопросов, а затем анализировался разрыв. Если разрыв перестает сокращаться, то это сигнал, что дело уже не в модели, а в данных или в промпте.
Открытые веса можно развернуть на своем контуре — данные не уходят наружу, а качество получается от команды, которая обучала модель на бюджете, недоступном отдельно взятому продукту. Для персональных и коммерческих данных это разумный компромисс между «отдать все наружу» и «растить свое».
Вывод: для быстрого старта лучше брать готовое. Даже если в продуктив пойдет своя модель, внешняя нужна в качестве точки отсчета — без нее не получится узнать, насколько свое качество далеко от достижимого. Поставщик отвечает за модель, а за ее работу на конкретной предметной области отвечаете вы — и замеряете тоже вы.
Разметка — скучный, но необходимый фундамент
Это самая скучная часть проекта и единственная, без которой остальное бессмысленно.
Для замеров качества ИИ-агентов прежде всего нужен репрезентативный датасет. Лучше всего взять реальные вопросы из промышленной системы: «как сменить тариф?», «за что списали комиссию?», «как работает пункт выдачи?», «когда приедет возврат?». Если системы еще нет, то ожидаемые вопросы собирают вместе со службой поддержки. Но надежнее попросить пользователей задать вопросы ИИ-агенту на прототипе — его собирают за несколько минут.
Затем надо сформулировать критерии «хорошего ответа». Можно предложить двенадцать критериев, сгруппированных по трем направлениям: правдивость, полнота и контекст. Правдивость — ответ не противоречит базе знаний. Полнота — пользователю не придется задавать уточняющий вопрос. Контекст — ответ относится к тому, что именно спросил человек, а не к похожей теме. Каждому критерию надо написать определение. Без определения критерий не работает. Два человека понимают «полноту» по-разному и размечают по-разному.
Критерии надо показать команде и спросить, нет ли дублирования. Пересекающиеся критерии — типичная болезнь первых версий инструкции по разметке: «полезность» и «полнота» на практике оказываются синонимами, а разметчик мучается.
Размечать лучше перекрестно силами команды: каждый диалог смотрят не менее двух человек, а расхождения разбирают вместе. Именно на этом шаге выясняется, можно ли по-разному толковать инструкцию по разметке.
На переписывание инструкции уходит несколько итераций — каждый прогон вскрывает неоднозначные формулировки и после правки разметку запускают заново. Ориентир — расхождение между разметчиками должно быть не более 7% размеченных диалогов. Но и этот показатель вводит в заблуждение без одного уточнения. Доля совпадений льстит тем сильнее, чем реже встречаются плохие ответы. Соотношение 76% хороших ответов и 93% совпадений соответствует каппе Коэна (статистическому показателю согласованности оценок между экспертами) около 0,8, то есть согласию на верхней границе «существенного». Но если бы плохих ответов было 5%, те же 93% совпадений давали бы каппу около 0,26 — согласия практически нет, оба разметчика почти всегда пишут «хорошо». Сравнивать разметчиков надо по каппе, а не по проценту совпадений.
Немного чисел. Контрольный датасет начинался с 50 вопросов и вырос до 200 по мере того, как в поток приходили новые сценарии. К регулярной разметке подключились 12 асессоров. Все показатели качества получены на контрольном датасете, а не на всем потоке.
Процесс дал понятную картину дефектов. Правдивость — 15% плохих ответов, полнота — 7%, контекст — 6%. За каждым показателем стояла своя причина: неверные данные, ответ не до конца, подмена задачи.
Вывод был неожиданным — для многих команд оказалось, что первая метрика проекта это не качество собственно ИИ-агента, а согласованность людей, которые его оценивают. Пока разметчики расходятся между собой, любой показатель качества не более чем шум.
При этом сойтись на 100% невозможно, люди всегда будут ошибаться — и это важно учитывать.
Редакция и асессоры
Инструкция по разметке — это не только про правдивые и полные ответы. Это еще и про то, как компания разговаривает с пользователем: тональность и манера речи (tone of voice). Поэтому к работе стоит подключить редакцию. ИИ-агент, который говорит правду, но не голосом компании, — плохой результат. Правила обращения к пользователю, допустимую длину ответа, запрет на канцелярит, формат списков и заголовков редакция соберет за неделю на основе уже действующих в компании норм, а затем вычитает текущие ответы агента и поправит промпт.
Один из примеров, на чем редакция настояла вопреки команде, — правило называть вещи ровно так, как они называются в интерфейсе. В базе знаний и интерфейсе раздел назывался «тарифный план», а агент, пересказывая своими словами, мог назвать его «условия обслуживания». Команде это казалось спором о синонимах. Однако оказалось, что дело не в синонимах — пользователь ищет на экране глазами ровно то слово, которое стоит в ответе агента. Не найдя его, он решает, что речь идет про другой раздел, и обращается к оператору, хотя ИИ-агент формально дал правильный ответ.
Асессорам разметку передают позже — когда инструкция перестает меняться. Это важно. Асессор работает строго по инструкции и иногда не догадается, что в ней имеется в виду, да и не спросит. Плохую инструкцию он размножит на сотни диалогов, а в результате будет получена смещенная недостоверная оценка качества ответов агента.
Практическое правило — передавать разметку внешним людям надо только после того, как две последние итерации инструкции не изменили результат на контрольной выборке.
Что можно автоматизировать
Критерии «хорошего ответа» ИИ-агента делятся на формальные и содержательные. Автоматизируются только первые. Формальные — для проверки которых достаточно самого ответа: тон, длина, структура, наличие запрещенных формулировок, соблюдение формата. Здесь автоматика работает хорошо и почти полностью заменяет ручной труд.
Первой следует автоматизировать тональность — вместе с проверкой на нецензурную лексику и грубость — и форматирование. Это два критерия из двенадцати — примерно шестая часть ручной разметки сразу и навсегда ушла из работы асессоров.
Содержательные критерии — правдивость и полнота. Для их проверки нужно знать правильный ответ, которого может и не быть: данных нет в базе знаний либо агент до них не дошел. Здесь применяют оценку языковой моделью — метод «модель как судья» (LLM-as-a-judge). Он работает: в исследовании [4] согласие модели-судьи с людьми оказалось на уровне согласия людей между собой. Требовать большего бессмысленно — если два эксперта расходятся, судья не может быть точнее их обоих.
У судьи есть систематические сбои, о которых стоит знать заранее: при сравнении двух ответов судья предпочитает тот, что стоит на определенном месте, а перестановка меняет результат (позиционное смещение) [5]. Это лечится рандомизацией порядка. Другой сбой — любовь к многословию: длинный структурированный ответ получает оценку выше при том же содержании. Для ИИ-агента это прямо противоречит продуктовой цели — говорить четко и по делу.
И главное. Судья не измеряет качество, а воспроизводит инструкцию по разметке в масштабе. Плохие критерии он размножит так же добросовестно, как и хорошие, поэтому его согласие с людьми надо измерять постоянно. Сравнивать нужно не с абсолютной шкалой — «судья прав в 95% случаев», как если бы для каждого вопроса существовал заранее известный эталонный ответ, — а с тем, насколько люди согласны между собой.
Вывод: формальное автоматизируют сразу, содержательное — только после того, как разметка людьми стала воспроизводимой. Это значит, что два разметчика на одном и том же диалоге приходят к одному решению, а повторный прогон того же датасета через месяц дает тот же результат.
Качество в темах
Общий показатель качества скрывает ровно то, что нужно найти (см. таблицу). Средние 76% складываются в основном из справок, потому что их было больше всего.
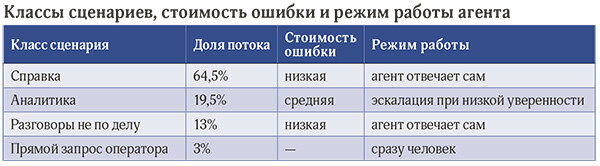
Разрез по темам показал другое — хуже всего ИИ-агент отвечал на вопросы про тарифы: за какие услуги берется комиссия, сколько она составляет в зависимости от категории. Причина оказалась технической — тарифы хранились длинными таблицами, ни одна из них не помещалась в контекст модели, поэтому поиск по базе знаний работал плохо. Базу знаний пришлось резать иначе, чем обычные тексты.
Тарифы — это еще и тема, где ошибка стоит дороже всего. Неверный ответ про то, где найти нужную настройку, стоит пользователю десятки минут рабочего времени. Неверный ответ про удержания стоит ему денег и дополнительного обращения в поддержку, а компании — доверия, которое возвращается месяцами. Из этого следует практическое правило про эскалацию. Типичная конструктивная ошибка — единый порог «если агент не уверен, зови оператора». Порогов должно быть столько, сколько классов сценариев.
Отдельный вопрос — откуда берется уверенность ИИ-агента в собственном ответе. Прямой вопрос модели «насколько ты уверена» дает плохо откалиброванное число, на которое нельзя ставить порог. Работают косвенные признаки: насколько релевантны найденные в базе знаний фрагменты, насколько сходятся между собой несколько независимых генераций на один и тот же запрос, что говорит модель-судья, есть ли в ответе утверждения без опоры на найденный текст, к какой теме относится запрос. Для чувствительных тем — тех, где ошибка стоит пользователю денег: тарифы, комиссии, удержания — на уверенность не полагаются вовсе. Такие запросы уходили в режим подсказки оператору всегда, независимо от того, что показывали признаки.
Контринтуитивный вывод: улучшать надо не там, где больше трафика, а там, где максимально произведение объема на стоимость ошибки. Эти две точки почти никогда не совпадают.
Мониторинг и откат
В промышленной эксплуатации ИИ-агент деградирует. Вопрос лишь в том, насколько быстро это станет заметно.
Ломается обычно не то, что ожидают. Обновление модели у поставщика меняет поведение сразу и заметно, но происходит редко и планируется заранее. Опаснее источники изменений, которые никто не планирует. База знаний в крупной компании правится десятками людей, не связанных с командой ИИ-агента, и любая правка меняет то, что агент находит по запросу, — в том числе по соседним темам, к которым документ напрямую не относится. Еще один источник — накопление правок в промпте: каждая закрывала конкретную жалобу, а через 50 итераций они уже противоречат друг другу.
Хорошая новость — часть сигналов не требует разметки и обновляется в реальном времени.
Доля эскалаций на оператора — самый общий индикатор качества агента, реагирует почти на все. Доля повторных обращений по той же теме за 24 и 48 часов — ловит формально верные, но бесполезные ответы. Распределение длины диалога — если растет число шагов до разрешения, значит, агент перестал понимать запрос с первого раза. Доля отказов от ответа.
Отдельно стоит завести регрессионный тестовый датасет — несколько сотен фиксированных запросов, которые прогоняются при каждом изменении промпта, модели или базы знаний. В такой датасет попадают частотные вопросы, все когда-либо найденные дефекты и пограничные случаи, когда правильное поведение — отказаться и позвать человека. Проверяются не тексты ответов, а свойства: есть ли нужный факт, нет ли запрещенного утверждения, случилась ли эскалация там, где она должна быть.
Деградирует не только ИИ-агент, но и разметка. Стандартный прием контроля — контрольные задания (honeypot): в поток асессоров подмешиваются диалоги с заранее известной правильной разметкой, причем асессор не знает, какие задания контрольные. По доле совпадений с эталоном считается его точность. Сложившаяся практика платформ разметки — примерно одно контрольное задание на пять рабочих и порог отсечения в районе 85–90%.
Контрольные задания решают две задачи. Первая очевидная: асессор, который перестал читать инструкцию, виден уже через несколько десятков заданий, а не через месяц. Вторая интереснее. Если точность падает сразу у всех асессоров, дело не в людях — изменился поток обращений. Появились сценарии, которые инструкция не описывает, и это ранний сигнал, что пора возвращаться к разметке.
Контрольные задания стареют так же, как все остальное, — их надо обновлять из свежего потока, иначе асессоры со временем начинают узнавать знакомые диалоги.
Мониторинг без регламента отката бесполезен. Регламент отката — заранее описанный порядок действий: кто и по какому сигналу возвращает агента к предыдущей версии промпта или базы знаний либо переводит его в безопасное состояние. Необходимый минимум — версионирование промптов и базы знаний с откатом за минуты, дежурный с явной ответственностью и на заранее описанное безопасное состояние, например режим, в котором агент не отвечает сам, а только подсказывает оператору. Методика управления рисками [6] отдельным пунктом (MANAGE 2.4) требует заранее назначить ответственных и предусмотреть механизм, позволяющий обойти, отключить или вывести из эксплуатации систему, которая работает не так, как задумано. Сопровождающий документ методики добавляет два условия: пороги срабатывания механизма определяются заранее, а на время отключения должен быть предусмотрен запасной режим работы.
Базу знаний надо писать под агента
ИИ-агент отвечает не «из головы», а ищет в базе знаний подходящие куски текста — фрагменты — и отвечает по ним. Это генерация с извлечением (retrieval-augmented generation, RAG). Значит, ответ будет хорошим только тогда, когда нужный фрагмент нашелся и остался понятным в отрыве от соседних.
Есть недорогой прием с измеренным эффектом. Специалисты компании Anthropic описали подход [7]: перед тем как положить фрагмент в поисковый индекс, к нему дописывают одну-две строки — из какого документа фрагмент и о чем этот документ. Доля случаев, когда нужный фрагмент не нашелся, падает почти вдвое. С добавлением переранжирования — еще вдвое. Изменилась не модель, а подготовка текста.
С таблицами хуже. Фрагмент нельзя сделать сколь угодно длинным: у поиска есть предел, который измеряется в токенах. Токен — кусок, на которые модель режет текст; для русского языка это в среднем два-три символа, то есть слово из шести букв весит два-три токена.
Устроен поиск следующим образом. Каждый фрагмент заранее прогоняют через эмбеддер — небольшую вспомогательную модель, которая переводит текст в набор чисел. Числа устроены так, что у близких по смыслу текстов они получаются похожими. Вопрос пользователя прогоняют через тот же эмбеддер и ищут фрагменты с самыми похожими числами. Поэтому вопрос «как поменять тариф» находит фрагмент «смена тарифного плана», где нет ни одного общего слова. За один раз распространенные эмбеддеры принимают 384–512 токенов — это примерно полстраницы текста или полтора десятка строк таблицы. Все, что длиннее, обрезается и в поиск не попадает.
Таблица тарифов на несколько десятков строк в такой фрагмент не помещается и не находится ни по одному запросу. Резать ее надо иначе, чем обычный текст, — по строкам. Каждая строка становится отдельным фрагментом вида «поле — значение», и в каждой повторяются заголовки колонок.
Можно сформулировать правила написания базы знаний для ИИ-агента.
- Фрагмент должен быть самодостаточным. Никаких «как указано выше» и «в предыдущем разделе»: агент увидит этот кусок отдельно от всех остальных.
- Заголовок формулируется как вопрос пользователя, а не как название раздела. «Почему заявка не проходит проверку» находится, а «Регламент проверки заявок» — нет.
- Аббревиатуры и внутренний жаргон раскрываются при первом появлении в каждом документе, причем не в глоссарии, а в тексте.
- Таблицы дублируются текстовым описанием. Одна строка таблицы — одно предложение с повторением заголовков колонок.
- Правки в базе знаний версионируются наравне с кодом, чтобы в случае внезапного ухудшения качества быстро откатиться.
Вывод: часть качества чинится не в промпте и не сменой модели, а редактурой документов. Это самая дешевая работа в проекте, но и самая недооцененная.
Чек-лист
Перечислим, что стоит «закрыть» до того, как озвучивать показатель качества ИИ-агента.
- Критерии сформулированы, и у каждого есть определение на два-три предложения.
- Критерии не пересекаются: команда проверила это вслух, а не в переписке.
- Разметка перекрестная, расхождения разобраны, инструкция переписана хотя бы дважды.
- Правила языка получены от редакции, а не придуманы командой.
- Асессоры подключены после того, как инструкция перестала меняться, и их точность контролируется скрытыми заданиями.
- Качество считается в разрезе тем, а не только на всем потоке.
- Пороги эскалации разные для разных классов сценариев, и есть безопасное состояние, куда можно перевести сервис за минуту.
- Промпты и база знаний версионированы, а откат занимает минуты.
Здесь нет пунктов про выбор модели — за несколько лет активного внедрения ИИ лидеры этого рынка сменились дважды, а вот этот список не изменился.
***
Предлагаемый подход рассчитан на поток, где есть что размечать, а если ИИ-агенту приходит несколько десятков обращений в день, то содержание 12 асессоров и контрольного датасета не окупится — надо начинать с еженедельной вычитки всех диалогов силами команды. Это позволит быстро найти ошибки в ответах и точки роста для ИИ-агента.
Завышенная и заниженная оценки качества берутся из показателя, за которым не стоит система измерения. Отличаются они только тем, кто платит за ошибку: когда оценка завышена — пользователь, потому что получает некачественного ИИ-агента; когда оценка занижена — команда, потому что тратит время на улучшения, ничего не меняющие.
Сотрудника не оценивают одним числом раз в квартал — обычно у него есть испытательный срок, регулярная оценка и руководитель, который читает его переписку с клиентами. ИИ-агенту нужно нечто похожее, и построить это придется команде: сформулировать критерии и написать к ним определения, разметить перекрестно силами команды, довести согласие разметчиков до приемлемой каппы, подключить редакцию, автоматизировать формальные критерии, считать качество в разрезе тем и завести регламент отката. Модель в этом списке — расходная деталь, а вот система измерения — нет.
Литература
1. Challapally A., Pease C., Raskar R., Chari P. The GenAI Divide: State of AI in Business 2025. — Cambridge: MIT Media Lab, Project NANDA, 2025. — 26 p.
2. Александр Огуречников. Риски и подводные камни ИИ-агентов // Открытые системы. СУБД. — 2026. — № 2. — С. 14–17. URL: https://www.osp.ru/os/2026/02/13060803 (дата обращения: 31.09.2026).
3. 2025: The State of Generative AI in the Enterprise. — Menlo Park: Menlo Ventures, 2025.
4. Zheng L., Chiang W.-L., Sheng Y., Zhuang S., Wu Z., Zhuang Y., Lin Z., Li Z., Li D., Xing E. P., Zhang H., Gonzalez J. E., Stoica I. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena // Advances in Neural Information Processing Systems 36 (NeurIPS 2023). — New Orleans, 2023. — P. 46595–46623.
5. Wang P., Li L., Chen L., Cai Z., Zhu D., Lin B., Cao Y., Liu Q., Liu T., Sui Z. Large Language Models are not Fair Evaluators // Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (ACL 2024). — Bangkok, 2024. — P. 9440–9450.
6. Artificial Intelligence Risk Management Framework (AI RMF 1.0). NIST AI 100–1. — Gaithersburg: National Institute of Standards and Technology, 2023.— 42 p.
7. Contextual Retrieval in AI Systems. — San Francisco: Anthropic, 2024. — URL: https://www.anthropic.com/engineering/contextual-retrieval (дата обращения: 16.08.2026).
Алина Романовская (denislina22@gmail.com) — руководитель направления, крупная финтех-компания (Москва). Статья подготовлена на основе материалов выступления на форуме «Управление данными 2026».